Рассказ на защите Где это в коде? Перейти к теме Выбери тему Начни здесь Нейрон и матрицы Активации Softmax и логиты Потери и градиенты Как сеть учится Учебные эксперименты Digits и лучшие настройки Словарик и методы Карта ноутбука Весь код построчно Рассказ на защите Активации Почему несколько линейных слоёв ещё не дают сложную модель.
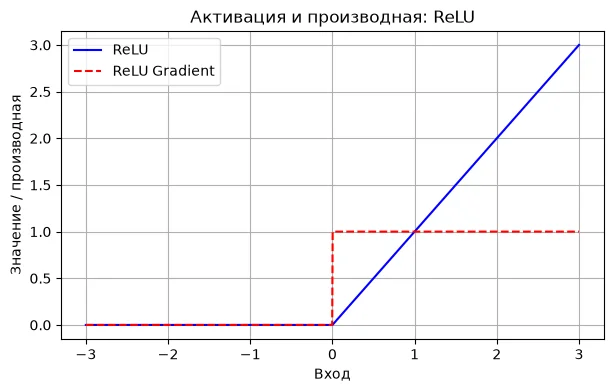
Активация меняет взвешенную сумму. Представь выключатель: отрицательный сигнал не проходит, положительный проходит. Это ReLU. Без таких преобразований несколько линейных слоёв можно свернуть в один.
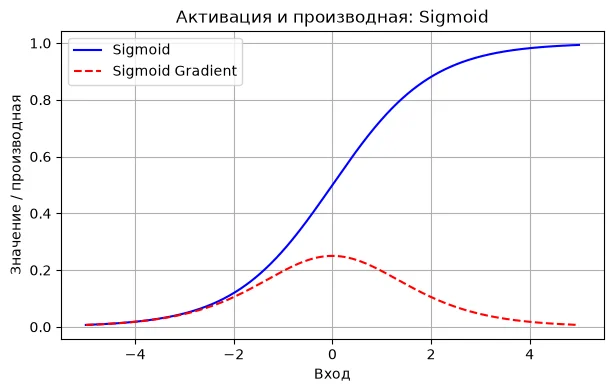
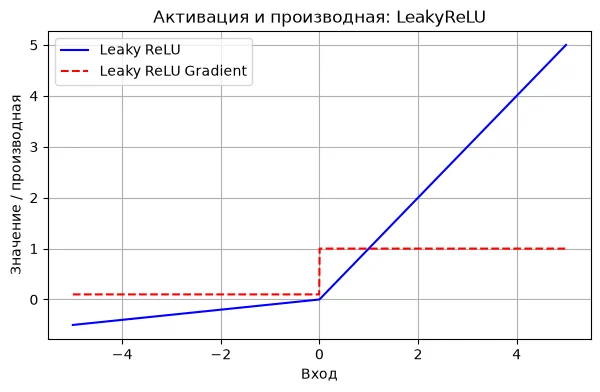
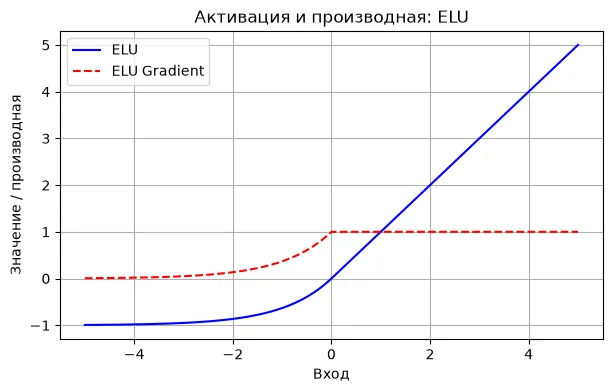
Функция Идея Производная Identity Ничего не менять: x → x 1 Sigmoid Сжать число в вероятность от 0 до 1 s(1-s), в нуле 0.25 ReLU Отрицательное заменить нулём 0 слева, 1 справа LeakyReLU Слева оставить маленький наклон α слева, 1 справа ELU Слева плавно приблизиться к -α α exp(x) слева, 1 справа
Производная говорит, насколько изменится выход при малом изменении входа. При x=-2 и α=0.1 LeakyReLU даёт -0.2, производная 0.1. ReLU там даёт 0 и производную 0.
Сравни выход и производную Вход x Ловушка Мёртвый ReLU постоянно получает отрицательный вход: его градиент нулевой. Но один мёртвый нейрон не означает, что остановилась вся сеть. На других путях градиент может проходить.
[7] / И20: class Identity(ActivationFunction): Код и построчный разбор 1 class Identity(ActivationFunction):
2 def __call__(self, x):
3 return np.asarray(x, dtype=float)
4
5 def grad(self, x):
6 return np.ones_like(x, dtype=float)Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 3 Преобразуем вход в числовой массив. Identity сохраняет сами значения. 5 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 6 Создаём массив единиц той же формы: производная Identity везде 1.
[9] / И25: class Sigmoid(ActivationFunction): Код и построчный разбор 1 class Sigmoid(ActivationFunction):
2 def __call__(self, x):
3 x = np.asarray(x, dtype=float)
4 small_exp = np.exp(-np.abs(x))
5 return np.where(x >= 0, 1 / (1 + small_exp), small_exp / (1 + small_exp))
6
7 def grad(self, x):
8 probabilities = self(x)
9 return probabilities * (1 - probabilities)Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 3 Приводим вход к массиву вещественных чисел, чтобы формула работала сразу над всеми элементами. 4 Считаем только экспоненту неположительного числа. Так большое положительное x не вызывает переполнение. 5 Выбираем две равносильные формы сигмоиды для положительных и отрицательных входов. На выходе вероятности от 0 до 1. 7 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 8 Вызываем прямую формулу текущей активации. self(x) означает вызвать __call__ этого объекта. 9 Производная сигмоиды: вероятность умножаем на единицу минус вероятность. В нуле получаем 0.25.
[12] / И32: class ReLU(ActivationFunction): Код и построчный разбор 1 class ReLU(ActivationFunction):
2 def __call__(self, x):
3 return np.maximum(x, 0)
4
5 def grad(self, x):
6 return (np.asarray(x) > 0).astype(float)Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 3 Каждый отрицательный элемент заменяем нулём. Положительные сохраняются. 5 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 6 Получаем 1 на положительной стороне и 0 на отрицательной и в нуле. В нуле это принятое соглашение.
[15] / И39: class LeakyReLU(ActivationFunction): Код и построчный разбор 1 class LeakyReLU(ActivationFunction):
2 def __init__(self, alpha=0.01):
3 self.alpha = alpha
4
5 def __call__(self, x):
6 x = np.asarray(x, dtype=float)
7 return np.where(x > 0, x, self.alpha * x)
8
9 def grad(self, x):
10 return np.where(np.asarray(x) > 0, 1.0, self.alpha)Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Конструктор вызывается при создании объекта. Запоминает настройки и создаёт начальное состояние. 3 Сохраняем коэффициент отрицательной ветки. Он задан вручную и в этой работе не обучается. 5 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 6 Приводим вход к массиву вещественных чисел, чтобы формула работала сразу над всеми элементами. 7 Положительные элементы сохраняем; отрицательные умножаем на alpha. Это LeakyReLU. 9 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 10 Производная равна 1 справа и alpha слева. В нуле используем alpha как соглашение.
[18] / И46: class ELU(ActivationFunction): Код и построчный разбор 1 class ELU(ActivationFunction):
2 def __init__(self, alpha=0.01):
3 self.alpha = alpha
4
5 def __call__(self, x):
6 x = np.asarray(x, dtype=float)
7 return np.where(x > 0, x, self.alpha * np.expm1(np.minimum(x, 0)))
8
9 def grad(self, x):
10 return np.where(np.asarray(x) > 0, 1.0,
11 self.alpha * np.exp(np.minimum(x, 0)))Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Конструктор вызывается при создании объекта. Запоминает настройки и создаёт начальное состояние. 3 Сохраняем коэффициент отрицательной ветки. Он задан вручную и в этой работе не обучается. 5 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 6 Приводим вход к массиву вещественных чисел, чтобы формула работала сразу над всеми элементами. 7 ELU справа сохраняет x, слева считает alpha*(exp(x)-1). minimum предотвращает лишнюю большую экспоненту. 9 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 10 Для положительных входов производная ELU равна 1, иначе используем выражение следующей строки. 11 На отрицательной стороне производная ELU равна alpha*exp(x).
Фактический вывод [10], исходная ячейка И26. Фактический вывод [13], исходная ячейка И33. Фактический вывод [16], исходная ячейка И40. Фактический вывод [19], исходная ячейка И47. Проверь себя Почему без активации слои схлопываются? Композиция аффинных функций остаётся аффинной: произведения весов объединяются, сдвиги тоже.
Почему сигмоида иногда плохо учится? На краях она почти плоская. Производная близка к нулю, при обратном проходе сигнал может затухать.
Что с производной ReLU в нуле? Математически её нет. Для алгоритма выбрали 0, как в PyTorch.
Вы сами реализовали активации? Да, в классах Identity, Sigmoid, ReLU, LeakyReLU и ELU. PyTorch только сравнивает значения и производные.
Одна фраза Активации позволяют сети строить нелинейную зависимость, а их производные нужны для обучения.