Рассказ на защите Где это в коде? Перейти к теме Выбери тему Начни здесь Нейрон и матрицы Активации Softmax и логиты Потери и градиенты Как сеть учится Учебные эксперименты Digits и лучшие настройки Словарик и методы Карта ноутбука Весь код построчно Рассказ на защите Softmax и логиты Десять оценок превращаются в десять связанных вероятностей.
Логиты являются необработанными оценками классов. Они могут быть отрицательными и не обязаны давать в сумме единицу. Softmax превращает их в вероятности.
Идея: положить каждому классу экспоненту его оценки, затем поделить на общую сумму. При одинаковых двух оценках [0,0] получаем [0.5,0.5].
pᵢ = exp(zᵢ) / Σ exp(zⱼ)
Вычитание максимума из всех оценок не меняет ответ: общий множитель сокращается. Это защищает от слишком больших экспонент.
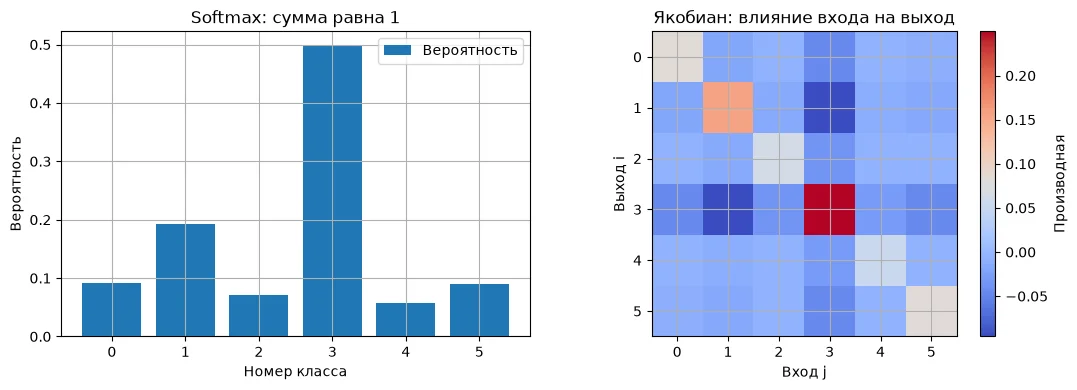
Что такое Якобиан Это таблица производных: строка обозначает выход, столбец вход. Softmax.grad возвращает весь Якобиан, потому что каждый выход зависит от всех входов. Для двух равных классов диагональ 0.25, вне диагонали -0.25.
Ловушка В тексте задания есть утверждение про независимость классов. Выходы Softmax связаны нормировкой. Ещё одна ловушка: нельзя ставить Softmax в последний слой и повторно применять его внутри CrossEntropy(use_softmax=True).
[21] / И53: class Softmax(ActivationFunction): Код и построчный разбор 1 class Softmax(ActivationFunction):
2 def __call__(self, x):
3 x = np.asarray(x, dtype=float)
4 shifted = x - np.max(x, axis=-1, keepdims=True)
5 exponents = np.exp(shifted)
6 return exponents / exponents.sum(axis=-1, keepdims=True)
7
8 def grad(self, x):
9 probabilities = self(x)
10 identity = np.eye(probabilities.shape[-1])
11 return (probabilities[..., :, None] * identity
12 - probabilities[..., :, None] * probabilities[..., None, :])Строка Что происходит 1 Объявляем класс: шаблон объекта с данными и методами. Это наша реализация. 2 Позволяет вызывать объект как функцию: например, Sigmoid()(x). Здесь вычисляется значение. 3 Приводим вход к массиву вещественных чисел, чтобы формула работала сразу над всеми элементами. 4 Из каждой строки вычитаем её максимум. Отношения экспонент не меняются, переполнение предотвращается. 5 Вычисляем экспоненты сдвинутых логитов. Все значения положительны или численно близки к нулю. 6 Каждую экспоненту делим на сумму в той же строке. Все вероятности строки дают 1. 8 Метод grad возвращает производную по входу функции, для потерь по прогнозам. 9 Вызываем прямую формулу текущей активации. self(x) означает вызвать __call__ этого объекта. 10 Создаём единичную матрицу: единицы на диагонали, остальные элементы нулевые. Она представляет символ Кронекера. 11 Первая часть Якобиана: диагональная матрица вероятностей. 12 Вычитаем внешнее произведение вектора на себя. Получаем и диагональные, и перекрёстные производные.
[22] / И54: z_range = np.array([[0.5, 1.25, 0.25, 2.2, 0.05, 0.495]]) Код и построчный разбор 1 z_range = np.array([[0.5, 1.25, 0.25, 2.2, 0.05, 0.495]])
2 softmax = Softmax()
3 softmax_values = softmax(z_range)
4 softmax_gradient = softmax.grad(z_range)
5 fig, axes = plt.subplots(1, 2, figsize=(11, 4))
6 axes[0].bar(range(6), softmax_values[0], label='Вероятность')
7 axes[0].set(xlabel='Номер класса', ylabel='Вероятность', title='Softmax: сумма равна 1')
8 axes[0].legend()
9 image = axes[1].imshow(softmax_gradient[0], cmap='coolwarm')
10 axes[1].set(xlabel='Вход j', ylabel='Выход i', title='Якобиан: влияние входа на выход')
11 fig.colorbar(image, ax=axes[1], label='Производная')
12 plt.tight_layout()
13 plt.show()
14 print('Сумма вероятностей:', softmax_values.sum())
15 print('Размер Якобиана:', softmax_gradient.shape)Строка Что происходит 1 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 2 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 3 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 4 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 5 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 6 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 7 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 8 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 9 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 10 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 11 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 12 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 13 Настраиваем график или показываем его. Эта строка не обучает модель и не меняет метрики. 14 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 15 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную.
[23] / И56: input = np.array([[1.0, 2.0, 3.0], Код и построчный разбор 1 input = np.array([[1.0, 2.0, 3.0],
2 [2.0, 7.0, 4.0],
3 [2.0, 2.0, 2.0]])
4
5 custom_output = Softmax()(input)
6 torch_output = F.softmax(torch.tensor(input), dim=-1).numpy()
7
8 print("Custom Softmax Output:")
9 print(custom_output)
10 print()
11 print("PyTorch Softmax Output:")
12 print(torch_output)
13
14 assert np.allclose(custom_output, torch_output)Строка Что происходит 1 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 2 Продолжение выражения из предыдущей строки: читай его вместе с открывающей скобкой. 3 Продолжение выражения из предыдущей строки: читай его вместе с открывающей скобкой. 5 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 6 Вычисляем правую часть и сохраняем результат под именем слева. Смотри назначение блока и размеры его входов выше. 8 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 9 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 10 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 11 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 12 Показываем полученный результат. Расчёт выполнен в переменных, а не вписан вручную. 14 Проверяем обязательное условие. При нарушении выполнение останавливается с ошибкой.
Фактический вывод [22], исходная ячейка И54. Сумма вероятностей: 0.9999999999999999
Размер Якобиана: (1, 6, 6)
Проверь себя Где Softmax в итоговой сети? При обучении он включён в CrossEntropy(use_softmax=True); после обучения отдельно превращает логиты final_model в вероятности.
Почему последний слой Identity? Он выдаёт логиты. Softmax уже учтён в функции потерь.
Почему grad возвращает матрицу? Потому что изменение одного логита влияет на все вероятности.
Чем отличается argmax? argmax только выбирает индекс максимума. Он не вычисляет вероятности и не обучает сеть.